Jev против пяти LLM: тест качества, скорости и стоимости отбора для построения RAG
Практика · RAG · LLM · Jev · скорость и стоимость
При построении RAG-системы модель выбирают под конкретную задачу: быстро отсеять ненужные документы, перепроверить спорные источники или подготовить ответ по найденному контексту. Требования к качеству, скорости и стоимости на этих этапах разные. В этой статье разбираем этап отбора данных перед индексацией: сравниваем Jev и пять LLM на 200 GitHub-проектах и показываем, как результаты помогают распределить задачи между моделями.
Для RAG нужна не одна «лучшая LLM», а подходящая модель на каждом этапе. В нашей выборке Jev оказался полезен для быстрого первичного отсева, Claude — для мягкой и быстрой перепроверки, Grok — для строгого отбора. Агрегатор моделей помогает проверить эти варианты на одинаковых данных и выбрать сочетание под требования системы.
Это продолжение статей «TypeSafe и Jev в Laravel» и «Локальная LLM в production: Ollama и Laravel».
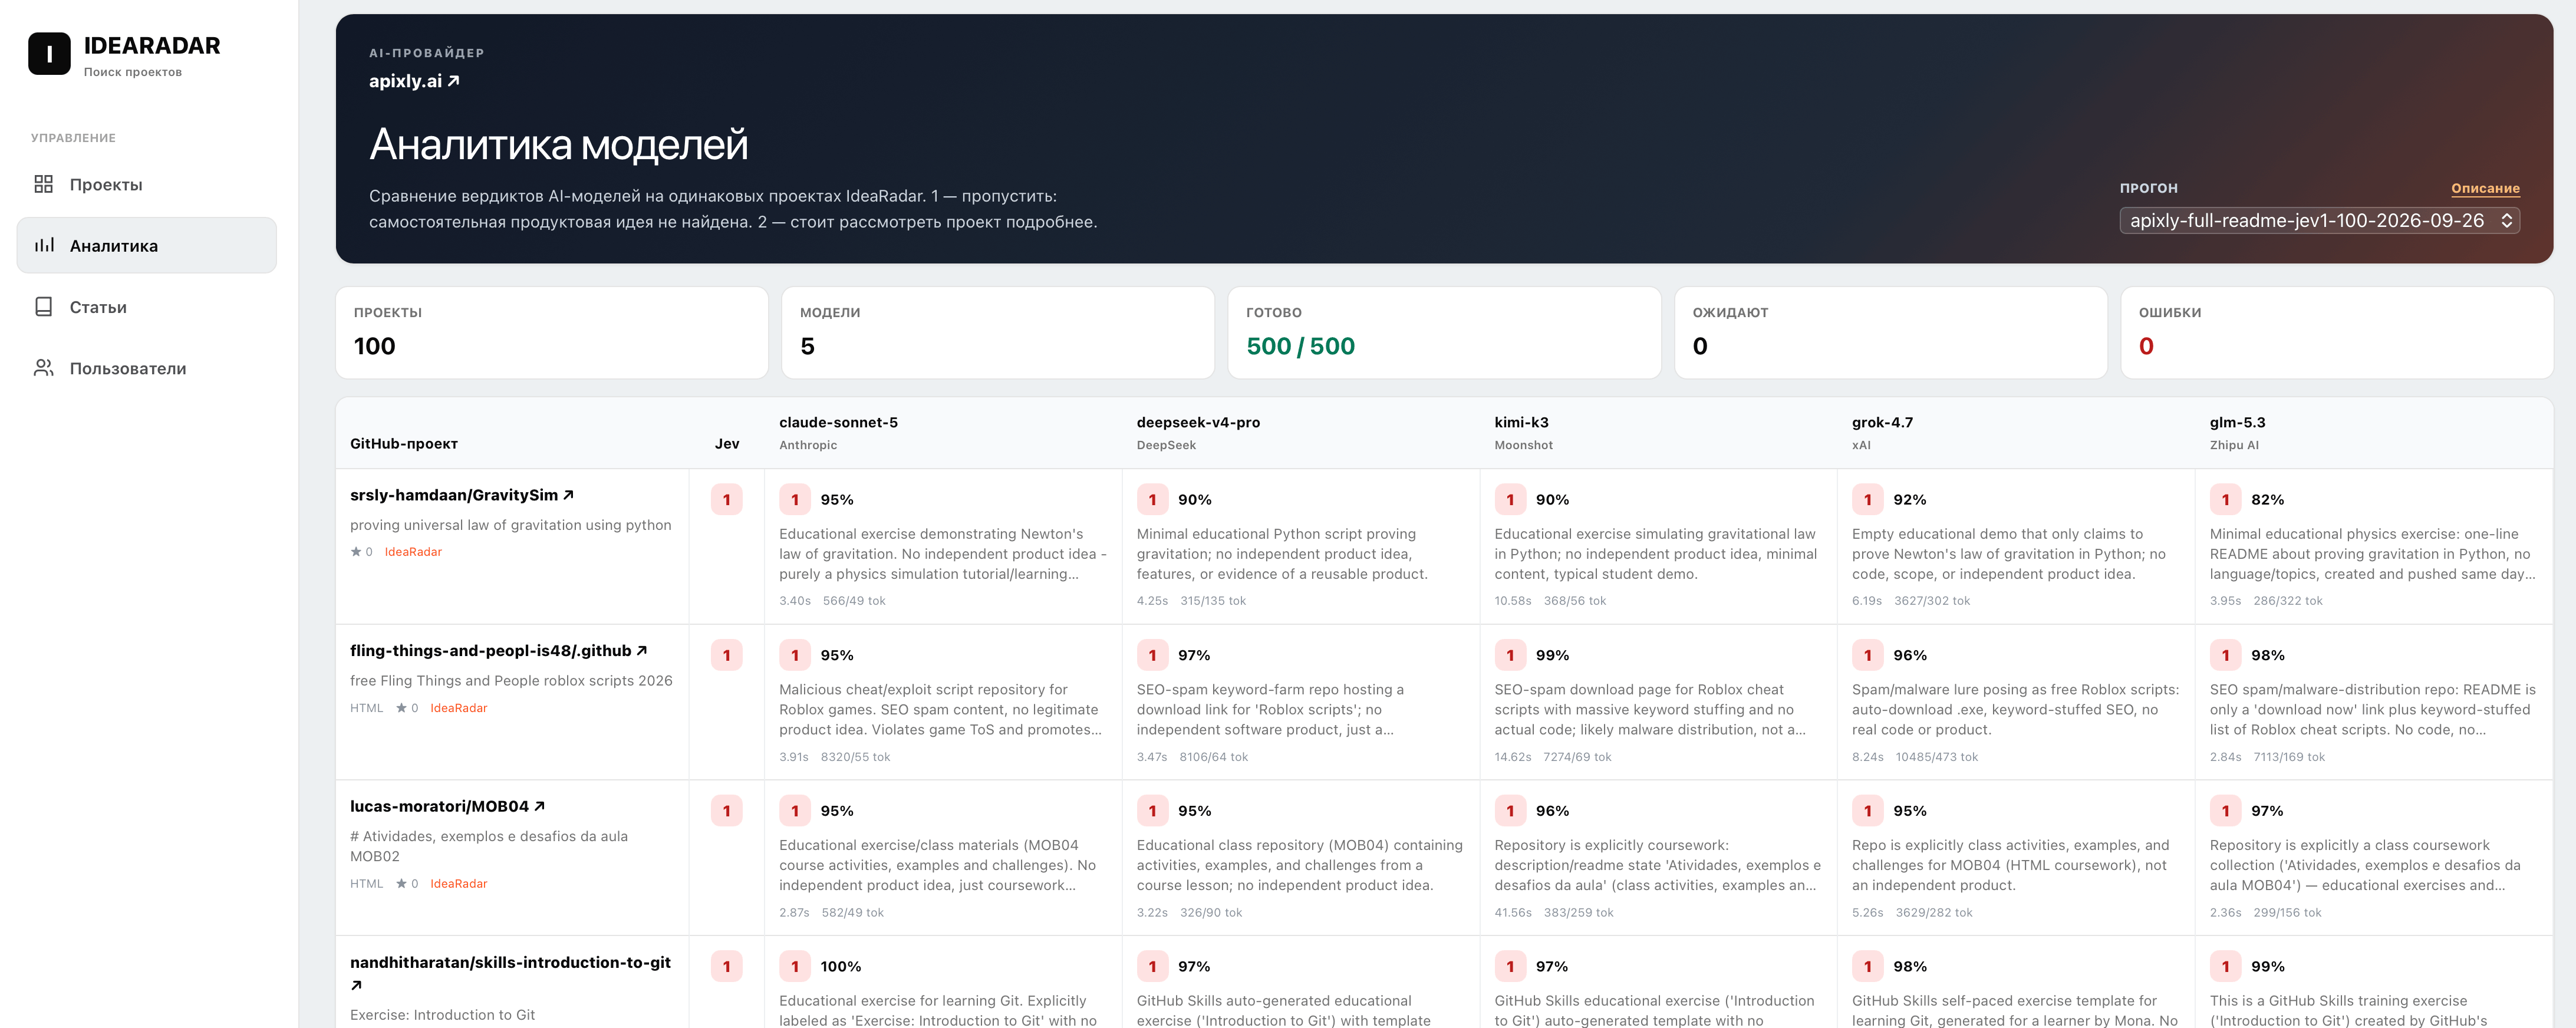
Все пять LLM в эксперименте запускались через единый OpenAI-совместимый API. Это позволило сравнить модели в одной интеграции: менять модель, сохраняя входные данные, формат ответа и способ измерения.
Зачем RAG-системе фильтр перед моделью
RAG и аналитические конвейеры редко упираются в «умную» модель на последнем шаге. Качество определяет то, что попадает в индекс и на глубокий анализ. Мусор в векторной базе — это лишние токены в контексте, ложные источники в ответах и деньги на каждом повторном запросе.
В IdeaRadar проекты проходят цепочку: сбор с GitHub, PHP-фильтр очевидного мусора, короткий AI-фильтр и глубокий анализ DeepSeek. Вопрос этой статьи — кто должен стоять на месте короткого фильтра и чего это стоит по качеству, скорости и деньгам.
Для RAG это задача подготовки корпуса: решить, какие источники стоит сохранять и индексировать. Здесь мы проверяем именно отбор проектов по README. Качество эмбеддингов, поиска, ранжирования найденных фрагментов и финальных ответов этот эксперимент не измеряет — для этих этапов нужны отдельные тесты на вопросах и документах вашей системы.
Как проводили эксперимент
Выборка
Проекты, прошедшие PHP pre-filter (pass или review) и уже размеченные Jev. Два независимых набора по 100 проектов без пересечений: Jev = 2 — «стоит рассмотреть» и Jev = 1 — «мусор».
Модели
claude-sonnet-5, deepseek-v4-pro, glm-5.3, grok-4.7, kimi-k3. Точные идентификаторы взяты из GET /v1/models шлюза, а не угаданы.
Один промпт для всех
Семантика как у Jev: 1 — мусор, 2 — стоит рассмотреть, при сомнении — 2.
Одинаковый вход
Полный нормализованный README, название, описание, топики и метаданные репозитория.
Строгий формат ответа
JSON:
{"verdict":1|2,"confidence":0-100,"reason":"..."}, без стриминга.Честный замер скорости
Внутри модели запросы идут последовательно, задержка измеряется только вокруг HTTP-вызова. Сырой ответ, токены, статус и хеш входа сохраняются.
Важная оговорка. Совпадение с Jev — не точность. Эталонной ручной разметки пока нет, поэтому мы смотрим на согласие моделей между собой и вручную разбираем спорные случаи.
Как агрегатор помогает выбрать модель для RAG
Сравнение быстро теряет смысл, если для каждой модели писать отдельный клиент, по-разному обрабатывать ошибки и собирать несовместимую статистику. Мы отправляли запросы на один OpenAI-совместимый endpoint, а модель меняли идентификатором из GET /v1/models. Это позволило оставить неизменными промпт, формат JSON, таймауты, логирование и измерение задержки.
Единый шлюз не делает ответы моделей одинаковыми и не отменяет различия провайдеров. Он убирает лишнюю переменную на уровне интеграции: эксперимент сравнивает поведение моделей, а не пять разных SDK. Для production это также упрощает запасной маршрут — при сбое одной модели задачу можно переключить на другую без переписывания всей цепочки.
Практическая польза агрегаторов моделей — возможность подбирать модель под этап RAG, а не строить всю систему вокруг первой подключённой LLM. Для фильтрации сравниваем ложные отказы и стоимость проверки; для интерактивного ответа — задержку и опору на найденные источники; для фонового анализа — полноту результата и цену обработки. Последние две задачи требуют собственной выборки: победитель в фильтрации не обязательно лучше генерирует ответы.
Рабочий порядок: собрать контрольную выборку с ручной разметкой, прогнать кандидатов через общий клиент, сравнить качество и p95 при нужной нагрузке, затем закрепить модель за конкретной задачей. Единый API упрощает повторные прогоны и замену кандидатов, но лимиты, параметры и формат ответа каждой модели всё равно нужно проверять.
Первая проблема: 24 пустых ответа из 500
В первом прогоне GLM-5.3 вернул 14 невалидных ответов, Kimi K3 — 10. Ошибки API не было: HTTP 200, но JSON оборван на середине.
Причина — лимит max_tokens. Обе модели рассуждают скрыто, даже когда их об этом не просят. У GLM все 14 ответов упёрлись ровно в 1 024 выходных токена, из которых 991–1 024 ушли на рассуждения. У Kimi — ровно в 256. На ответ из одной цифры и короткой причины места не осталось.
После повышения лимита (GLM — 4 096, Kimi — 2 048) и повтора тех же запросов с тем же входом получили 500 из 500 валидных ответов. Один из повторных ответов GLM занял 3 875 выходных токенов.
У рассуждающих моделей
max_tokens— это бюджет на размышление плюс ответ. Маленький лимит не экономит деньги, а превращает оплаченный запрос в мусор. Невалидные ответы нужно считать отдельной метрикой, а не тихо отбрасывать.
Тест 1: что LLM думают о «стоящих» проектах Jev
100 проектов, которым Jev поставил 2.
| Модель | Согласна с Jev | Считает мусором | Средняя уверенность |
|---|---|---|---|
| Claude Sonnet 5 | 79% | 21% | 78 |
| GLM-5.3 | 66% | 34% | 74 |
| DeepSeek V4 Pro | 65% | 35% | 75 |
| Kimi K3 | 56% | 44% | 74 |
| Grok 4.7 | 41% | 59% | 80 |
| Голосов «стоящий» | 0 | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|---|
| Проектов | 19 | 9 | 10 | 9 | 14 | 39 |
19 проектов все пять моделей единогласно признали мусором. Мы проверили их вручную — модели правы: учебный ML-пайплайн на публичном датасете, личное портфолио, сайт конкретной компании, коллекция шейдеров, школьные проекты с прямым указанием на это в README, Docker Compose-обвязка чужих сервисов. Ещё 19 проектов большинство моделей отнесло к мусору тремя или четырьмя голосами.
Итого: 38 из 100 «стоящих» по Jev большинство LLM отклоняет. Для следующего этапа это лишняя нагрузка: каждый такой проект уходит на дорогой глубокий анализ или в RAG-индекс.
Строгость моделей сильно различается
Попарное согласие показывает, что модели — не взаимозаменяемые оценщики. GLM-5.3 и Kimi K3 совпали в 90% случаев; Claude и GLM, DeepSeek и GLM — по 85%; Claude и Grok — только в 60%.
Grok 4.7 — самый строгий
Отказы конкретные: жёстко прописанные пути /home/li в «продукте», дашборд под двух агентов одного бизнеса, скилл из массового каталога шаблонов, документация без кода.
Claude Sonnet 5 — самый мягкий
Ближе всех к Jev. Иногда это оправдано, иногда нет: групповой учебный проект с кодом курса в описании Claude отправил в «стоящие» из-за нетривиальной архитектуры.
Выбор модели здесь — выбор политики. Если пропустить хорошую идею дороже, чем проверить лишнюю, нужна мягкая модель. Если дорог следующий этап — строгая.
Тест 2: можно ли доверять отказам Jev
100 новых проектов, которые Jev отклонил.
| Модель | Согласна с Jev | Нашла «стоящие» |
|---|---|---|
| DeepSeek V4 Pro | 100% | 0 |
| Grok 4.7 | 100% | 0 |
| Kimi K3 | 99% | 1 |
| GLM-5.3 | 98% | 2 |
| Claude Sonnet 5 | 92% | 8 |
91 проект — единогласный мусор. Семь проектов получили один голос «стоящий», два — два голоса. Ни одного проекта с большинством «стоящий».
Разбор расхождений подтверждает Jev. Пять из восьми «находок» Claude — почти одинаковые форки инструмента обхода блокировок Discord от разных безымянных аккаунтов. Такие серии клонов — типичный признак массово сгенерированных репозиториев, а не самостоятельного продукта. Остальные спорные случаи — личная база знаний, маркетинговый сайт без кода продукта и шаблон Vite без реализации.
Скорость: для RAG важен хвост, а не медиана
Если фильтр стоит в интерактивном контуре — пользователь загрузил документы и ждёт ответа, — решает не средняя задержка, а 95-й процентиль и максимум. Именно их человек видит как «зависание».
| Модель | p50 | p95 | max |
|---|---|---|---|
| Jev (прошлая статья) | 0,6 с | 0,7 с | — |
| Claude Sonnet 5 | 3,6 с | 5,7 с | 14,2 с |
| DeepSeek V4 Pro | 4,8 с | 10,5 с | 18,1 с |
| GLM-5.3 | 10,9 с | 20,7 с | 28,3 с |
| Kimi K3 | 10,9 с | 29,5 с | 52,1 с |
| Grok 4.7 | 11,7 с | 21,8 с | 28,3 с |
| Модель | p50 | p95 | max |
|---|---|---|---|
| Claude Sonnet 5 | 3,4 с | 4,6 с | 4,9 с |
| GLM-5.3 | 4,0 с | 15,6 с | 27,1 с |
| DeepSeek V4 Pro | 4,3 с | 11,0 с | 18,8 с |
| Grok 4.7 | 6,0 с | 13,7 с | 17,5 с |
| Kimi K3 | 6,6 с | 21,6 с | 41,6 с |
Разница на порядок
Jev быстрее самой быстрой LLM примерно в 6 раз и в 15–20 раз быстрее рассуждающих моделей.
Задержку создают скрытые рассуждения
GLM на очевидном мусоре тратил в среднем 278 токенов на рассуждения и отвечал за 4 с, на пограничных проектах — 556 токенов и 11 с. Модель «думает» там, где решение сложное, и пользователь это ощущает.
Длинные хвосты
У Kimi K3 максимум 52 с, а в более раннем прогоне на 500 проектов был ответ за 149 с. Для синхронного RAG-запроса это недопустимо без таймаута и запасного маршрута.
Самая предсказуемая модель
Claude Sonnet 5: на очевидных случаях разброс от 3,4 до 4,9 с.
Сколько занимает весь поток
В базе IdeaRadar на момент эксперимента было 26 634 проекта, прошедших PHP-фильтр. Оценка по средней задержке:
| Схема | По очереди | 10 потоков |
|---|---|---|
| Только Jev | ≈ 4,7 ч | ≈ 0,5 ч |
| Только Claude Sonnet 5 | ≈ 27 ч | ≈ 2,7 ч |
| Только Kimi K3 | ≈ 66 ч | ≈ 6,6 ч |
| Jev + Claude только для Jev = 2 | ≈ 4,7 ч + 18 ч | ≈ 2,3 ч |
Расчёт ориентировочный: при параллельной нагрузке задержки шлюза и провайдера могут расти, а лимиты запросов у каждого провайдера свои.
Стоимость за 1 000 проверок
Цены — фактические тарифы шлюза в тех группах, через которые шли запросы (за 1 млн токенов, вход/выход): Claude Sonnet 5 — $0,40/$2,00; DeepSeek V4 Pro — $0,858/$2,574; GLM-5.3 — $0,70/$2,20; Grok 4.7 — $0,20/$0,60; Kimi K3 — $1,95/$9,75. Расчёт по нашим токенам совпал с биллингом: $4,62 против $4,54 за все ~3 000 запросов эксперимента, разница — скидки на кеш.
| Модель | Пограничные проекты | Очевидный мусор |
|---|---|---|
| Claude Sonnet 5 | $0,97 | $1,10 |
| Grok 4.7 | $1,38 | $1,12 |
| DeepSeek V4 Pro | $2,12 | $1,56 |
| GLM-5.3 | $2,47 | $1,66 |
| Kimi K3 | $4,30 | $3,92 |
Цена за токен обманчива
Grok 4.7 вдвое дешевле Claude по входным токенам, но шлюз насчитывал ему около 4 460 входных токенов на запрос против 1 400–2 000 у остальных при одинаковом промпте. Kimi K3 дорог из-за тарифа на выход, GLM — из-за объёма рассуждений.
Считайте цену решения
Сравнивать нужно стоимость одного ответа, а не прайс-лист. Самая быстрая модель в этом тесте оказалась и самой дешёвой за 1 000 проверок.
Какую модель выбрать под конкретную задачу RAG
Ниже — отправные точки для выбора по результатам нашего теста отбора README. Это роли в обработке данных, а не общий рейтинг интеллекта моделей. Перед переносом на другую предметную область проверьте кандидатов на своей размеченной выборке.
Jev: первый фильтр корпуса
Кандидат для большого потока, где нужна быстрая предварительная оценка. В прошлом тесте медиана составила 611 мс; в этой выборке ни один из 100 отказов не получил большинства голосов «стоящий». Положительные решения требуют перепроверки.
Claude Sonnet 5: мягкий отбор
Кандидат, когда важно сохранить больше потенциально полезных источников и быстро вернуть решение. На пограничных проектах p95 — 5,7 с, стоимость — $0,97 за 1 000 проверок. Мягкость означает и больше лишних пропусков.
Grok 4.7: сократить лишнюю обработку
Кандидат, когда следующий этап дорог и допустим более строгий отбор. Отклонил 59% положительных решений Jev — больше остальных. Для RAG с высокой ценой потери полезного источника сначала нужно измерить ложные отказы.
DeepSeek V4 Pro: ещё один кандидат
В нашей выборке отклонил 35% положительных решений Jev, между Claude и Grok; p95 — 10,5 с, стоимость — $2,12 за 1 000 проверок. Его стоит включить в сравнение, если крайние варианты отбора не подходят.
GLM-5.3 и Kimi K3: проверить пользу рассуждений
Кандидаты для отдельного прогона спорных случаев, если допустимы большие задержки. В этом тесте GLM и Kimi совпали в 90% решений; это не доказывает более высокую точность. Дополнительные токены оправданы только измеримым улучшением на вашей задаче.
Генератор ответа: отдельный выбор
Этот тест не определяет лучшую модель для финального ответа RAG. Сравните кандидатов на вопросах к своему корпусу: правильность, ссылки на источники, ответы при недостатке данных, задержка и стоимость. Агрегатор помогает провести такое сравнение через тот же клиент.
Как собрать отбор данных для RAG из нескольких моделей
| Решение Jev | Что говорят LLM | Можно ли доверять |
|---|---|---|
| 1 — мусор | 0 из 100 с большинством «стоящий», 91% — единогласно мусор | Да, отсекать сразу |
| 2 — стоит рассмотреть | 38 из 100 большинство считает мусором, 19 — единогласно | Нет, нужна перепроверка |
Правила кодом
Отсечь очевидное без AI: профили, пустые репозитории, шаблоны и дубли.
Jev на весь поток
Быстрый (0,6 с), предсказуемый и надёжно отсекает мусор. На нашей базе это около 37% проектов, которые дальше не идут.
LLM только для Jev = 2
Claude Sonnet 5 — если важнее не потерять идею и держать задержку низкой. Grok 4.7 или DeepSeek V4 Pro — если важнее разгрузить дорогой следующий этап.
Глубокий анализ
Индексация и дорогая обработка запускаются только после второго фильтра.
По нашим цифрам такая схема убирает из дорогого этапа около трети шума, который пропустил бы один Jev, и при этом не гоняет LLM по очевидному мусору.
Что ещё проверить перед production
- Ручная разметкаПроверить 100–200 спорных проектов. Согласие моделей — сильный сигнал, но не эталон.
- Две разные моделиНа пограничных случаях пары с согласием 60–75% дают больше информации, чем почти одинаковые оценщики.
- Таймаут и fallbackПри длинном хвосте задержки вернуть ответ Jev или перенести LLM-проверку в очередь.
- Лимиты ответаНастроить
max_tokensотдельно для каждой модели и считать невалидные ответы отдельной метрикой. - Каталог моделейПроверять реальные идентификаторы, назначение и доступность моделей у выбранного провайдера.
- Доступность провайдераGemini 3.1 Pro и GPT-5.6 в наших smoke-тестах отвечали HTTP 503, поэтому в сравнение не вошли.
Быстрая специализированная модель и универсальная LLM не конкурируют, а дополняют друг друга. Jev хорошо говорит «нет» и делает это за доли секунды. LLM нужны там, где Jev говорит «да», — и там важно выбрать не «самую умную» модель, а модель с подходящей строгостью, предсказуемым хвостом задержки и понятной ценой за решение.
Частые вопросы о выборе моделей для RAG
Какая модель оказалась лучшей?
Универсального победителя нет. Claude Sonnet 5 был самым быстрым и мягким оценщиком, Grok 4.7 — самым строгим, а GLM-5.3 и Kimi K3 чаще тратили время и токены на рассуждения. Выбор зависит от цены ложного отказа и стоимости следующего этапа.
Может ли Jev полностью заменить LLM?
Нет. В этом тесте отказам Jev можно было доверять, но его положительные решения оставались шумными: 38 из 100 проектов большинство LLM признало мусором. Поэтому Jev подходит для первого фильтра, а пропущенные им проекты нужно перепроверять.
Почему рассуждающая модель может вернуть пустой ответ?
Лимит max_tokens расходуется и на скрытое рассуждение, и на финальный ответ. Если бюджет слишком мал, модель успевает потратить его на анализ, но не завершает JSON. Лимит нужно настраивать по каждой модели и контролировать невалидные ответы.
Как считалась стоимость 1 000 проверок?
Мы сохраняли фактическое количество входных и выходных токенов каждого запроса, применяли тариф соответствующей группы и сверяли расчёт с биллингом шлюза. Поэтому сравнивалась цена готового решения, а не только стоимость миллиона токенов в прайс-листе.
Чем агрегаторы моделей помогают при построении RAG?
Они упрощают доступ к разным моделям через общий API. Можно прогнать одинаковую выборку, сравнить качество, задержку и стоимость, а затем выбрать отдельные модели для фильтрации, анализа и ответа пользователю. Параметры и доступность каждой модели нужно проверять отдельно.
Можно ли выбрать модель для всей RAG-системы по этому тесту?
Нет. Мы измеряли отбор GitHub-проектов по README перед дальнейшей обработкой. Для поиска, ранжирования и генерации ответов нужны свои контрольные задания. Результаты статьи помогают выбрать кандидатов на роль фильтра и показывают, как организовать сравнение моделей для других этапов.
Подобрать модели для своей RAG-системы
Предыдущие части: TypeSafe/Jev против Ollama · локальная LLM через Ollama и Laravel.
RAG · Jev · Claude · DeepSeek · GLM · Grok · Kimi · Laravel