Перевод PDF-документов на Laravel: почему мы отказались от OCR и перешли на DeepL API
Технический кейс · Laravel · PDF · DeepL API · очереди
Backend должен был принимать документы, переводить их в фоне и хранить исходные и готовые файлы. Первую версию мы спроектировали как цепочку OCR и перевода текста, но затем заменили её интеграцией с DeepL Document API.
Главная мысль: смена архитектуры не всегда означает добавление ещё одного слоя. Иногда полезнее передать целостную задачу специализированному API и оставить приложению то, что оно делает лучше: доступ, статусы, очереди и хранение.
Задача заказчика
Пользователь загружает документ, выбирает язык и позже получает готовый файл. Оригинал и результат сохраняются, длительная обработка не блокирует HTTP-запрос, а сбой внешнего сервиса не теряет задачу.
Кроме вызова переводчика нужны проверка файла, статусы, фоновые задания, повторы и скачивание. Пользоваться системой могут только учётные записи, активированные администратором.
Первоначальная архитектура: OCR и перевод как отдельные этапы
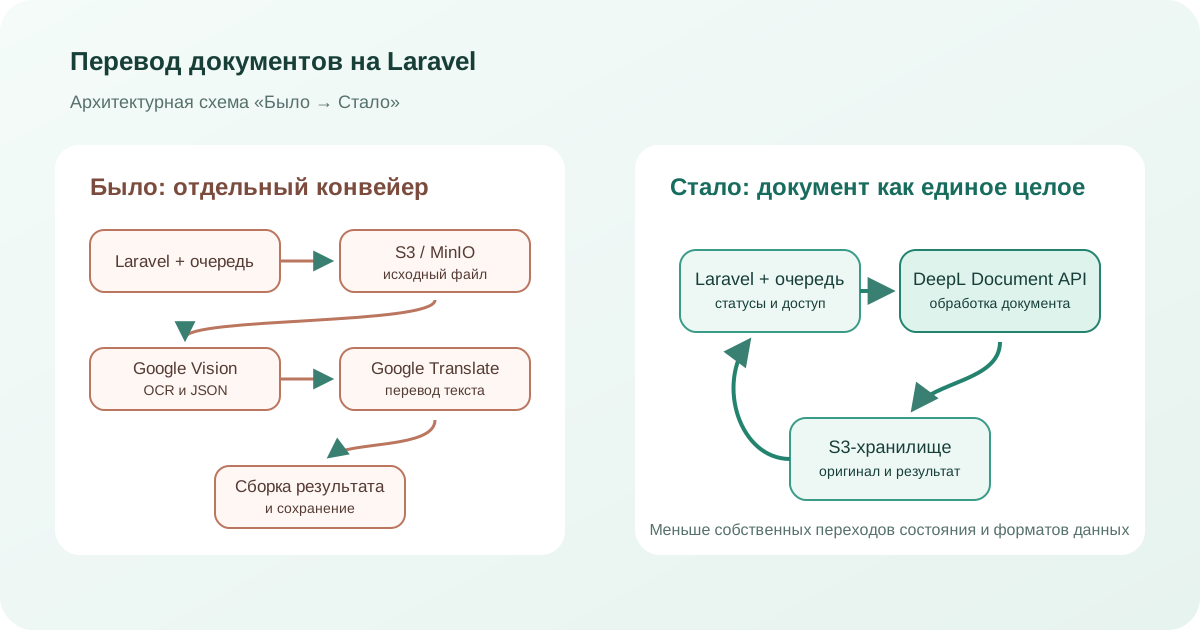
Laravel управлял процессом, PostgreSQL хранил пользователей и статусы, MinIO — файлы. Google Cloud Vision извлекал текст из PDF, Google Translate переводил его, Laravel Queue выполнял длительные операции.
Принять файл
Проверить загрузку, создать запись и сохранить оригинал.
Запустить OCR
Передать PDF в распознавание и дождаться текста со структурой страниц.
Перевести текст
Разбить материал на части, вызвать API и сохранить ответы.
Собрать результат
Сопоставить перевод со страницами и сохранить выходной файл.
Схема оправдана, если распознанный текст нужен и для других задач. Но файл, OCR-операция, JSON, фрагменты перевода и результат живут в разных состояниях.
Где появляется основная сложность
Документ — не строка
После OCR нужно связать перевод со страницами, таблицами, колонками и подписями.
Асинхронность
Для каждого внешнего этапа нужны статусы, таймауты и безопасные повторы.
Промежуточные данные
OCR-ответам и фрагментам перевода нужны хранение, права доступа и очистка.
Согласованность
База, MinIO и облачный API завершают операции в разное время, но дублей быть не должно.
Для PDF и TIFF Google описывает OCR как асинхронную операцию: исходный файл и JSON-результат размещаются в Cloud Storage, а состояние проверяется отдельно. Это ещё один полноценный workflow внутри общего workflow приложения.
Почему архитектуру изменили
Заказчик предложил перейти на DeepL Document API. Смысл был не в том, что «один сервис всегда лучше двух»: приложению не требовался распознанный текст для поиска или аналитики. Ценностью оставался готовый файл.
Document API принимает и возвращает документ. Из нашего кода исчезают модель OCR-результата, нарезка текста и собственная сборка PDF — меньше переходов и промежуточных форматов.
Что здесь нельзя утверждать без отдельного теста: что новая схема всегда дешевле, быстрее или точнее. Эти показатели зависят от типов файлов, языков, объёма и критериев качества. В проекте подтверждена передача изменений заказчику, но окончательная приёмка и измеренные production-результаты не подтверждены.
Новая реализация на DeepL Document API
Загрузка
Laravel валидирует файл, создаёт запись и сохраняет оригинал в S3.
uploadedОтправка
Job передаёт файл и язык в DeepL, затем сохраняет document ID и ключ.
submittedПроверка состояния
Очередь опрашивает API с задержкой, не создавая повторный перевод.
translatingПолучение
Worker скачивает готовый файл и сохраняет его в S3.
completedОшибка
Документ получает явный статус, а журнал — причину без ключей и содержимого.
failed
У DeepL это штатный трёхшаговый протокол: загрузить документ, проверить состояние, скачать результат. Но очередь всё равно нужна. Она отделяет пользовательский запрос от внешнего API, управляет задержками и позволяет восстанавливать обработку после сбоя worker.
Управление доступом
Регистрация не открывает перевод: учётную запись активирует администратор. Сервер проверяет право при создании задания, просмотре статуса и скачивании результата.
- АктивацияДоступ включается администратором для конкретного пользователя.
- ПринадлежностьПользователь видит и скачивает только собственные документы.
- Ключ APIСекрет хранится на backend и никогда не передаётся в браузер.
- ЖурналированиеФиксируются переходы статусов и ошибки, но не содержимое конфиденциальных документов.
Сколько стоит перевод документов через API
Считать нужно полную стоимость. У цепочки OCR + перевод складываются OCR, перевод символов, хранилище, workers, трафик и сопровождение сборки результата. Если текст нужен другим функциям, расходы могут быть оправданы.
У Document API расчёт проще, но есть особенности тарифа. В правилах учёта DeepL API указано, что для PDF, DOC/DOCX, PPTX и XLSX при файловом переводе учитывается минимум 50 000 символов на документ, даже если фактического текста меньше. Поэтому множество коротких PDF может оказаться менее выгодным сценарием, чем несколько крупных документов.
| Что считать | OCR + перевод | Document API |
|---|---|---|
| Облачная обработка | Страницы OCR + символы перевода | Тарифицируемые символы с правилами для файлов |
| Хранение | Оригинал, OCR-данные, фрагменты, результат | Оригинал и результат |
| Разработка | Связать несколько API и собрать документ | Реализовать жизненный цикл одной операции |
| Эксплуатация | Больше состояний, повторов и точек диагностики | Меньше состояний, но зависимость от возможностей провайдера |
Оценка строится на тестовой выборке: документы в месяц × форматы и объём × целевые языки, плюс хранение, трафик и сопровождение. Тарифы и лимиты нужно проверять перед расчётом.
Когда OCR + перевод всё ещё оправданы
Собственная цепочка нужна, если текст используется для поиска, извлечения полей, RAG, ручной корректуры или особой сборки результата. Она позволяет независимо выбирать OCR и переводчик.
Document API подходит, когда вход и выход — целые поддерживаемые файлы, а промежуточный текст не нужен. Это не универсальная победа сервиса, а точное совпадение API с задачей.
Частые вопросы о переводе документов
Почему нельзя просто извлечь текст из PDF?
Потому что PDF хранит представление страницы, а не обязательно логическую структуру документа. Колонки, таблицы и подписи требуют дополнительных правил.
Нужна ли Laravel Queue при использовании DeepL?
Да. Перевод документа — длительная внешняя операция. Очередь управляет проверкой статуса, повторами и восстановлением после временных ошибок.
Где хранятся готовые переводы?
После скачивания из API результат сохраняется в S3-совместимом хранилище рядом с исходным документом, но с отдельным ключом и статусом.
Всегда ли Document API дешевле?
Нет. Итог зависит от тарифа, размеров и количества файлов, языков и стоимости сопровождения. Для коротких файлов важно учитывать минимальный тарифицируемый объём.
Когда следует оставить отдельный OCR?
Когда нужен сам распознанный текст: для поиска, извлечения полей, аналитики, RAG, ручной проверки или подключения нескольких переводчиков.
Можно ли вызывать DeepL прямо из браузера?
Нет, API-ключ должен оставаться на сервере. Backend также проверяет права пользователя, формат файла и принадлежность документа.
Как избежать повторного перевода одного файла?
Задание связывается с локальной записью и внешним document ID. Worker проверяет текущее состояние перед отправкой и не создаёт новую операцию при обычном retry.
Где заказать похожий backend?
Я разрабатываю Laravel backend и API: загрузку файлов, очереди, интеграции внешних сервисов, управление доступом и хранение результатов.
Нужно автоматизировать обработку документов?
Спроектирую backend для загрузки, распознавания, перевода и хранения файлов — с очередями, статусами, доступом и интеграцией подходящего API без лишних технологических слоёв.
Laravel · PostgreSQL · S3 / MinIO · DeepL Document API · OCR · Google Cloud Vision · Google Translate · Queue